大模型直接开机械臂,行吗
论文 2026 年 9 月 21 日挂上 arXiv,是预印本,还没经过同行评审。文中的榜单数据是 2026 年 9 月 10 日的快照。
先说结论
这篇论文是 An Unexpected Robot Policy: Early Evaluations of GPT-6 Astra on RoboDojo and Beyond,作者来自 RoboDojo、RoboProbe 两个团队,以及港大、清华、伯克利、普林斯顿、MIT、北大等高校。它问了一个很直接的问题:不做任何机器人方面的训练,通用大模型能不能自己控制机械臂?
- GPT-6 Astra 能,而且在仿真榜单上排第一。 在 RoboDojo 的 42 个仿真任务上,它的平均成功率是 22.48%,高于榜单上全部 40 个专门为机器人训练的模型(其中最好的是 19.34%)。
- 别的大模型基本不能。 用同一套接口,GPT-5.5 的成功率是 0.88%,DeepSeek-Flash 是 1.92%。这个结果只说明 Astra 做到了,不能推广成"大模型都能开机械臂"。
- Astra 的能力很不均衡。 需要"看懂、想明白"的任务,它远好于专门的模型;需要精确用力、跟上移动物体、两只手配合的任务,它几乎做不成。
- 给它看一次示范,成功率反而下降;但被故意干扰时,它能在同一次任务里发现问题、自己纠正。
- 上真机测试时,研究者因为安全问题叫停了:模型多次发出不合理的动作,弄坏了设备,没有人受伤。
所以这篇论文的意义在于证明了"能做到",并没有证明大模型可以替代专门训练的机器人模型。
一、机器人的"慢脑"和"快脑"
今天的机器人系统,大多分成两层来做:
- 慢脑(论文里叫 System 2):一个能看图的大模型,负责理解任务、拆步骤,比如"先拿起红杯子,再放到架子上"。
- 快脑(System 1):一个专门训练的动作模型,负责把"拿起红杯子"变成每秒几十次的关节指令。这类模型叫 VLA(视觉-语言-动作模型),或者 WAM(世界-动作模型),常见的有 π0、OpenVLA 等。
两层分工的理由很简单:大模型懂语义,但慢,也没学过怎么用力;动作模型手快,但理解能力有限。
论文测的是另一种做法,叫 LLM as policy(让大模型直接当控制策略):去掉快脑,由大模型直接决定机械臂往哪移。
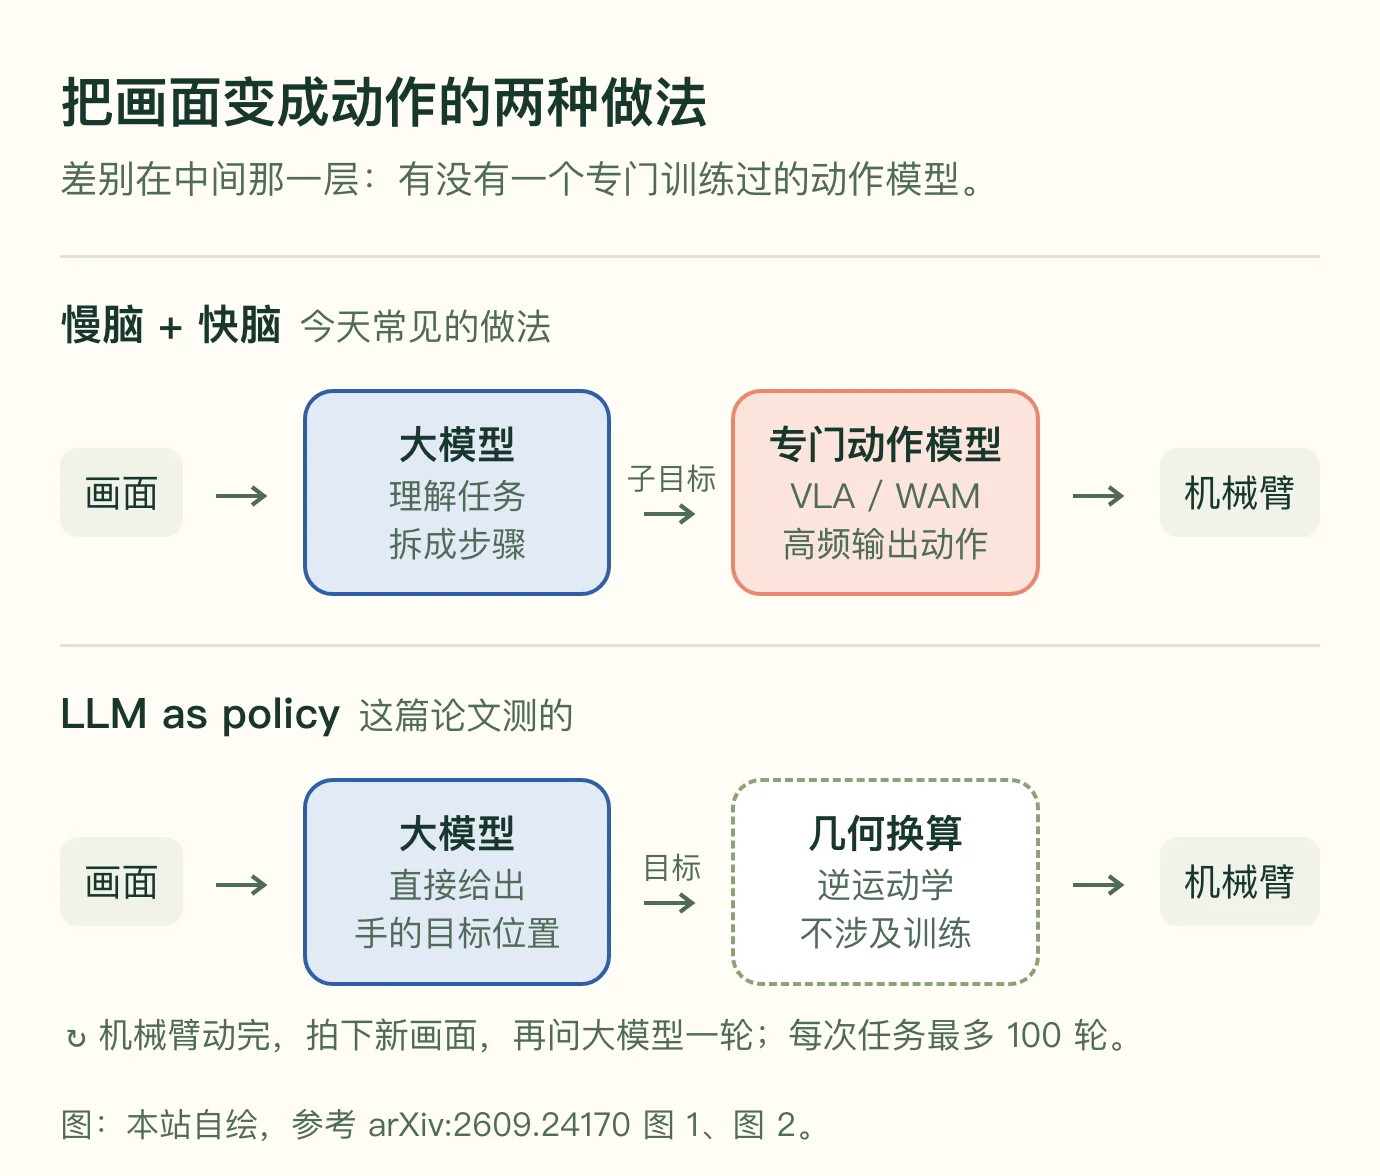
具体规则是这样的:
- 每一轮,模型看到三路彩色画面(头部一路、两只手腕各一路)和两只机械臂当前的位置,画面只保留最近两轮。
- 模型只能调用两个工具:
move_eef给出手的目标位置、朝向和夹爪开合;give_up表示这次任务没救了。 - 没有"抓取""放下"这类现成的动作,因为那等于替模型完成了一部分任务。
- 从目标位置换算成关节角度,用的是逆运动学,这是纯几何计算,不涉及任何训练过的模型。
- 模型拿不到深度信息,也拿不到物体的真实坐标,所有距离都要靠看图估计。
- 每次任务最多调用模型 100 次,也就是说机械臂每动一步,都要等大模型想一轮。
二、成绩:一个第一,两个接近零
RoboDojo 是一个机器人操作基准,有 42 个任务,分成五类能力:泛化、精度、长流程、记忆、开放式任务。官方规则是每个任务跑 50 次,所以一个模型要跑 2,100 次。
| 模型 | 平均成功率 | 在 43 个条目里的排名 |
|---|---|---|
| GPT-6 Astra | 22.48% | 1 |
| DM0.5(最强的专门模型) | 19.34% | 2 |
| DeepSeek-Flash | 1.92% | 28 |
| GPT-5.5 | 0.88% | 33 |
DeepSeek-Flash 因为成本原因,每个任务只跑了 10 次。三个大模型用的是完全相同的接口和换算程序,Astra 和 GPT-5.5 之间却差了约 25 倍,所以差距没法用这套接口来解释。
这个"第一"有两个前提,论文自己写得很清楚:
- 双方拿到的信息不一样。 大模型除了官方任务指令,还拿到了从 RoboDojo 网站整理出来的任务说明和评分标准;榜单上的专门模型没有用这些信息重跑。
- 只跑了一个随机种子,没有重复多轮来估计波动。
三、强在哪,弱在哪
把五类能力分开看,Astra 的领先几乎全部来自"开放式任务"和"泛化"两类:
- 开放式任务:Astra 31.00%,DM0.5 只有 2.08%。
- 泛化:Astra 30.50%,DM0.5 是 10.95%。
- 精度:Astra 只有 4.00%,最强的专门模型是 20.42%。
- 长流程:Astra 8.25%,最强的专门模型是 32.25%。
落到具体任务上,分化更明显:
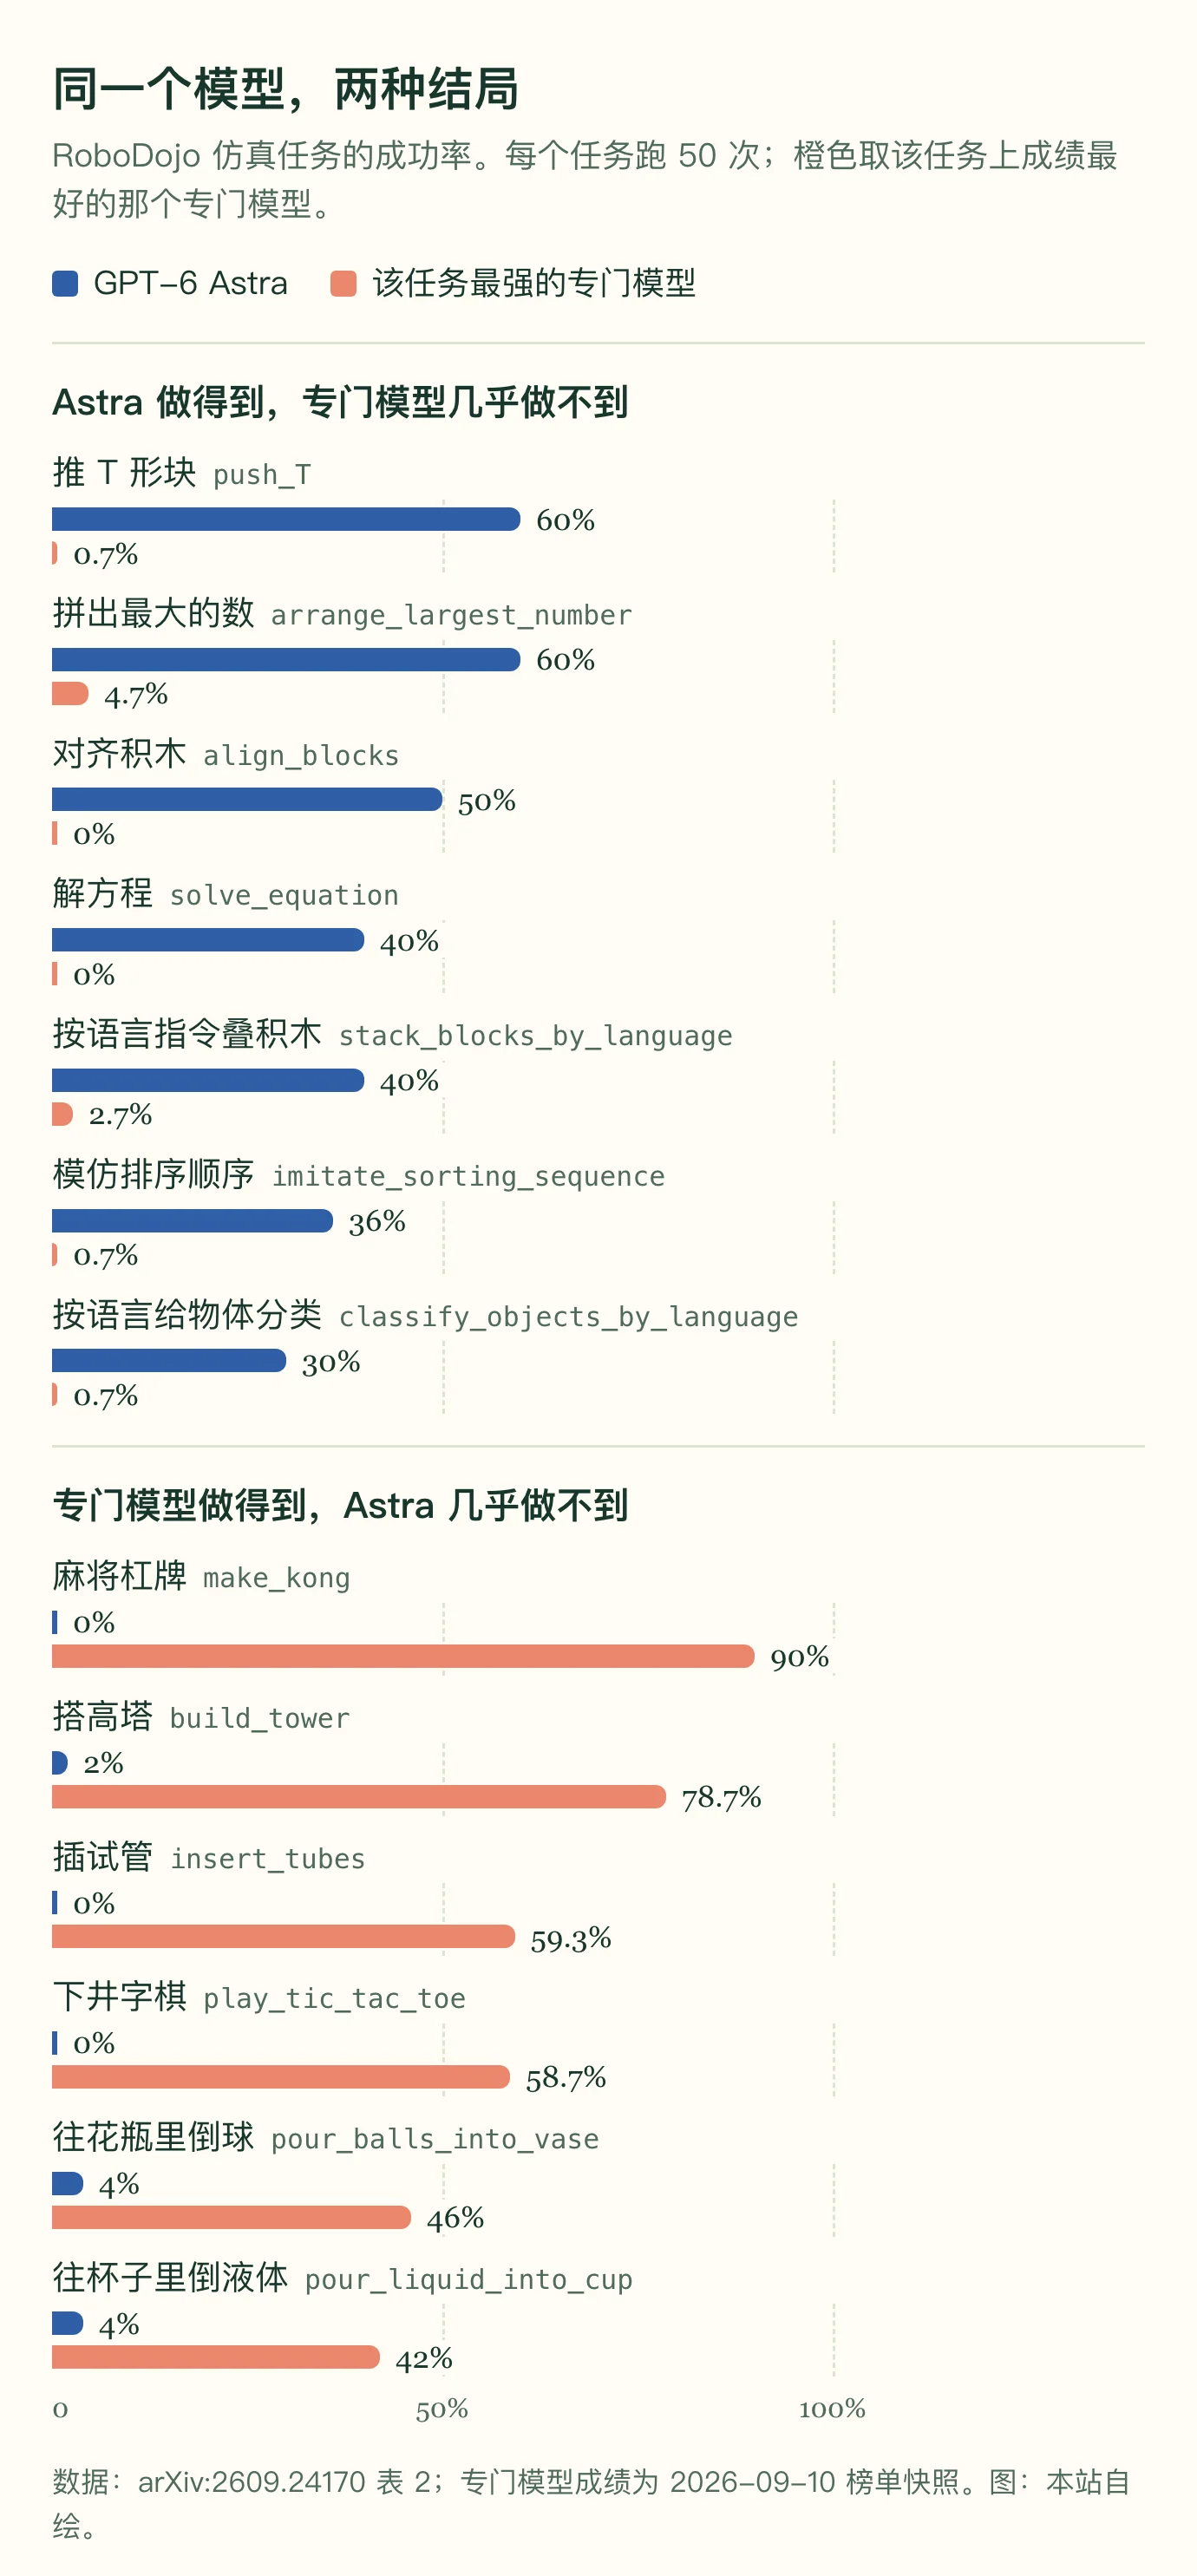
Astra 做得好的,几乎都要先"想明白"才能动手:解方程、拼出最大的数、按语言指令叠积木、按语言给物体分类、模仿一段排序顺序。这些任务上,最强的专门模型成功率也低于 5%。
Astra 做不好的,难点在手上:把试管插进架子、一块块搭高塔、往杯子里倒液体。专门模型在这些任务上能做到约 40% 到 80%,Astra 低于 5%。
最能说明问题的是 make_kong,一个麻将"杠牌"任务。论文的案例里,Astra 能从自己的牌里挑出和对手打出的牌相同的那张,说明它看懂了;但 50 次里一次也没完成,而最强的专门模型能完成 90%。看懂了,手跟不上。
论文记录的典型失败有三类:
- 动态控制:去抓传送带上移动的物体,抓空了。
- 双手配合:两只手都用上了,但交接失败。
- 周围物体:伸手拿下一块积木时,把已经搭好的塔碰倒了。
还有一些失败是抬的高度不对、接近的角度不对、纠正得太晚。作者把这类问题归结为缺少"物理常识",也就是对接触、力度和碰撞的直觉。不过他们也承认,这些失败可能部分来自接口:只有彩色画面没有深度,只能一步一步地给目标位置,没法表达连续的接触动作。
也有一些让人意外的好表现:插试管时,拿着试管的手挡住了视线,Astra 会把另一只手腕上的相机移过去看架子;分类任务里,它会两只手各拿一个物体。不过"用空闲的手腕相机看一看"这条建议,研究者事先写在了提示词里。
四、给它看示范,反而更差
研究者从 34 个任务里各取 10 种摆放,共 340 组,测试给一次示范有没有用。示范来自同一个任务的另一种摆放:
- 不给示范:成功率 22.9%(78/340)。
- 给图像加动作轨迹的示范:17.9%(61/340)。
- 给文字描述的示范:12.9%(44/340)。
下降主要发生在它本来就能做成的任务上:这些任务的成功率从 41.1% 降到 31.1%(图像示范)和 23.2%(文字示范);本来做不成的任务,示范几乎没帮上忙。
作者提出两种可能的解释,都没有证实:一是它的瓶颈在手上不在理解,示范帮不上;二是它把示范里那种摆放的位置照搬到了当前场景。论文也说明了,这只是"一种示范、一种放法"的结果,不能据此说示范学习对大模型没用。
五、被干扰时,它会自己改
另一组实验故意给模型添乱。任务是"按指令拿起某个物体",选了 8 种它在正常情况下都能完成的摆放,每种干扰各跑一次:
| 干扰方式 | 成功次数 |
|---|---|
| 不干扰 | 8/8 |
| 画面上下翻转 | 8/8 |
| 画面左右镜像 | 6/8 |
| 去掉头部相机 | 6/8 |
| 只剩右手腕相机 | 3/8 |
| 每次移动随机偏 10 厘米左右 | 3/8 |
| 坐标轴正负颠倒 | 4/8 |
比成功次数更有意思的,是模型每一步写下的笔记(以下是意译):
- 左右镜像时:一开始用错了手,后来写道"画面显示右臂才在剪刀旁边,把左臂收回,用右手抓"。
- 坐标颠倒时:写道"手腕画面里看到了桌子靠近我的边缘,前后方向估反了",然后往回移。
- 随机偏移时:写道"旋转到了 45 度,但位置偏了 129 毫米",接着继续修正直到抓住。
这说明它能在同一次任务里根据结果调整动作。但证据很薄:每种情况只有 8 次;8 种摆放是专门挑的"正常时都能成功"的;坐标颠倒时,工具说明里的坐标范围也跟着变了,等于给了提示。论文也没有对比专门模型在同样干扰下的表现。
六、上真机:因安全问题叫停
RoboDojo 还有一套真机测试,Astra 没有跑完。原因是模型多次发出不合理或不安全的动作,其中几次弄坏了设备,没有人受伤。
研究者保留了 33 次试验,覆盖 12 个任务和三种机械臂,只有一次完全成功(叠碗),平均成功率约 3%。这是叫停前后挑出来的样本,不能代表真机上的一般水平,但方向很清楚:在仿真里看起来"懂了",不等于在真实世界里能安全地做到。 作者在伦理声明里也写到,这种系统需要独立的安全检查和急停机制,不能只靠模型自己判断。
七、桌面之外:弹钢琴
论文附录还有两个不计入排名的实验。一个是让 Astra 控制能走动的人形机器人,有走过去抓东西、坐下再抓的视频,但没有统计成功率。
另一个更有意思:让 Astra 控制两只灵巧手(Shadow Hand)在仿真里弹 88 键钢琴。这次它不是一步一步给目标,而是自己写一段控制程序,在仿真里反复试、反复改,不能看参考答案,也不能训练神经网络。弹得准不准,用 F1 分数衡量,1 是满分:
- 《小星星》单手:0.907,试了 22 次,约 31 分钟。
- 《小星星》双手:0.902,试了 33 次。作为参照,用强化学习训练出来的方案在同一套评估里是 0.886。
- 肖邦夜曲片段(117 个音):0.599,试了 150 次还没到它给自己定的 0.9。
把弹《小星星》的程序直接拿去弹别的曲子,结果时好时坏:C 大调音阶 0.903,D 大调音阶只有 0.556;只是升 2 个或降 3 个半音,分数就掉了 0.22 到 0.25。
这篇论文该怎么读
我自己的理解是三点:
- "看懂"可以直接变成动作,这条路是通的。 常见的做法是大模型只做规划,动手交给专门模型。Astra 在一个公开、完整的仿真榜单上表明,至少对需要理解的任务,大模型可以自己动手,而且比专门模型做得好。
- 快脑短期内还替代不了。 精确用力、跟上移动的物体、两只手配合,这些恰恰是工厂和家庭里最常见的动作,Astra 在这些地方明显不行,上真机还出了安全问题。更现实的方向,可能是让大模型多管一点,专门模型继续负责手上的精细活。
- 结论要打折扣读。 只有一个模型表现突出;只跑了一个随机种子;大模型多拿了任务说明;作者里有 RoboDojo 基准团队自己的成员,这不是独立第三方的评测;Astra 是闭源模型,无法排除训练数据里混进了相关材料。
论文标题里的"意外",指的是一个没为机器人专门训练过的模型,在机器人榜单上排了第一。但同一篇论文也写明了它的局限:仿真里的第一和真实世界里能安全用起来,中间还差很远。
主要来源
- 论文:An Unexpected Robot Policy: Early Evaluations of GPT-6 Astra on RoboDojo and Beyond(arXiv:2609.24170)
- 作者的在线报告,含真机视频:robodojo-benchmark.com/report/gpt-6-astra-eval
- RoboDojo 基准论文:arXiv:2607.04434